Implementando uma Lista Ligada Dupla
Introdução
Se você acompanhou a nossa implementação da Lista Ligada Simples (Singly Linked List), viu como o encadeamento dinâmico de nós resolve problemas de tamanho fixo que encontramos nos Arrays tradicionais. No entanto, a lista simples possui uma limitação clara: só podemos navegar em uma única direção, da cabeça (head) para a cauda (tail). Se estivermos no meio da lista e precisarmos acessar o elemento anterior, teremos que recomeçar a busca desde o início.
É para resolver esse problema que entra em cena a Lista Duplamente Ligada (Doubly Linked List). Nela, cada nó possui conhecimento tanto do seu sucessor quanto do seu antecessor. Utilizamos um dos pilares da Orientação a Objetos: a Herança. para estender a nossa classe anterior (SLinkedList) e re-aproveitar toda a lógica que já funciona, sobrescrevendo apenas os métodos que precisam lidar com as novas referências.
Evoluindo os Nós: A classe DNode
Na nossa lista simples, utilizamos a classe Node, que guardava o valor e a referência para o próximo nó (next). Para a lista dupla, precisamos de uma evolução desse nó, adicionando uma referência para o nó anterior (prev).
Em vez de recriar tudo do zero, criamos a classe DNode que herda de Node:
package structures.linkedList;

public class DNode<E> extends Node<E> {
    private DNode<E> prev;

    public DNode(E element, DNode<E> prev) {
        super(element);
        this.prev = prev;
    }

    public DNode<E> getPrev() {
        return prev;
    }

    public void setPrev(DNode<E> prev) {
        this.prev = prev;
    }
}
A grande novidade aqui é a referência prev (previous/anterior). Note como o construtor utiliza o super(element) para delegar a inicialização do valor e do next para a classe pai, focando apenas em configurar o ponteiro anterior.
A Estrutura DLinkedList e a introdução do Tail (Cauda)
Agora vamos à estrutura principal. Nossa DLinkedList irá herdar de SLinkedList. Ao fazermos isso, herdamos automaticamente o head e o count (que foram declarados como protected na classe pai, permitindo esse acesso). Porém, com a lista dupla, ganhamos um superpoder: a capacidade de manter uma referência direta para o último elemento da lista, que chamaremos de tail (cauda).
package structures.linkedList;

public class DLinkedList<E> extends SLinkedList<E> {
    private DNode<E> tail;

    public DLinkedList() {
        super();
        tail = null;
    }
Manter o tail nos traz uma vantagem gigantesca de performance: inserir ou remover no final da lista agora é uma operação imediata, sem precisarmos percorrer todos os nós desde o head.
Inserindo elementos: Sobrescrevendo o método Insert
Como a manipulação de referências agora é dupla (temos que conectar a “ida” e a “volta”), a lógica de inserção muda. Por isso, utilizamos a anotação @Override para sobrescrever o método insert da classe pai.
Como a manipulação de referências agora é dupla (temos que conectar a “ida” e a “volta”), a lógica de inserção muda. Por isso, utilizamos a anotação @Override para sobrescrever o método insert da classe pai.
    @Override
    public void insert(int index, E element) throws IndexOutOfBoundsException {
        if (index < 0 || index > this.size()) throw new IndexOutOfBoundsException("Index: " + index + ", Size: " + this.size());

        DNode<E> node = new DNode<>(element, null);

        if(index == 0){
            if(this.getHead() == null){
                this.head = node;
                this.tail = node;
            } else {
                DNode<E> current = (DNode<E>) this.getHead();
                node.setNext(current);
                current.setPrev(node);
                this.head = node;
            }
        } else if(index == this.size()){
            DNode<E> current = this.tail;
            current.setNext(node);
            node.setPrev(current);
            this.tail = node;
        } else {
            DNode<E> previous = (DNode<E>) this.getElementAt(index - 1);
            DNode<E> current = (DNode<E>) previous.getNext();

            node.setNext(current);
            previous.setNext(node);
            current.setPrev(node);
            node.setPrev(previous);
        }
        this.count++;
    }
Dividimos essa lógica em três cenários práticos:
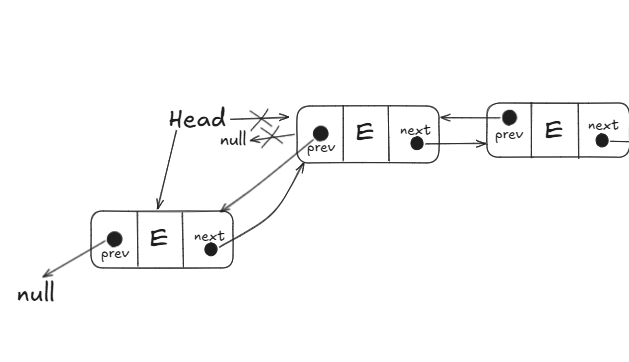
- Cenário 1 (Inserção no início - index 0): Se a lista estiver vazia (head == null), o novo nó será tanto a cabeça quanto a cauda. Se já houver elementos, o novo nó aponta para o antigo head, e o prev do antigo head aponta para o novo nó, que se torna a nova cabeça.
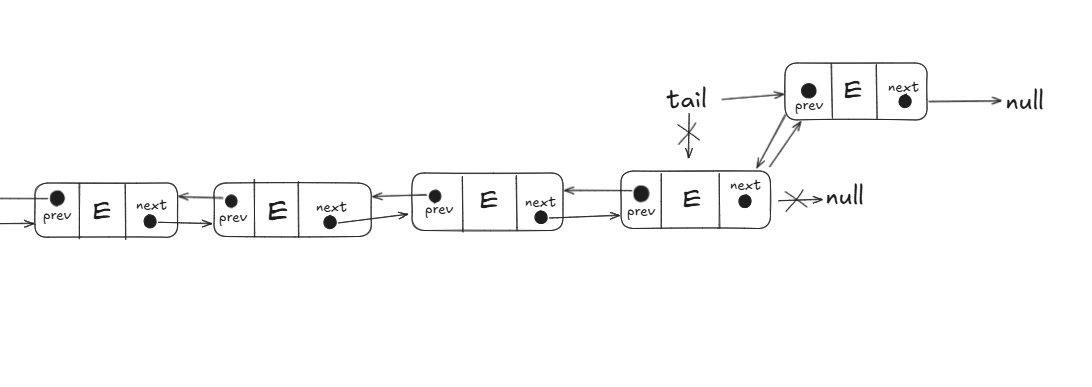
- Cenário 2 (Inserção no final - index == size): Pegamos a cauda atual, fazemos o next dela apontar para o novo nó, o prev do novo nó apontar para a cauda antiga, e atualizamos o ponteiro tail para esse novo último elemento.
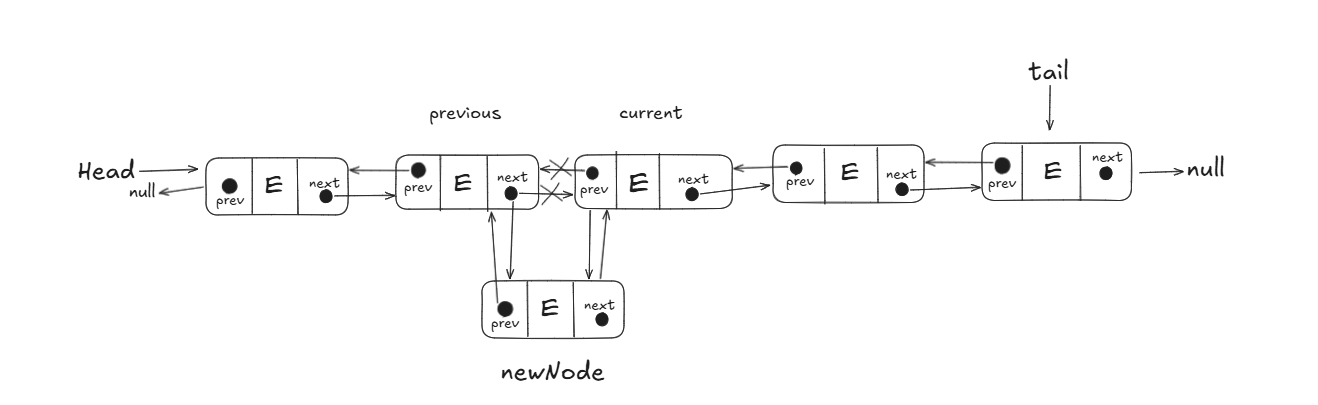
- Cenário 3 (Inserção no meio): Buscamos o nó anterior (previous) e o nó atual daquela posição (current). O novo nó é encaixado no meio conectando as quatro pontas: o seu next e prev, além de atualizar o next do previous e o prev do current.
Removendo elementos: Sobrescrevendo o método RemoveAt
A remoção exige o mesmo cuidado redobrado com as conexões duplas para não deixarmos nós “perdidos” na memória.
    @Override
    public E removeAt(int index) throws IndexOutOfBoundsException {
        if (index < 0 || index >= this.count) throw new IndexOutOfBoundsException("Index: " + index + ", Size: " + this.count);

        DNode<E> current = (DNode<E>) this.head;

        if(index == 0){
            this.head = current.getNext();
            if(this.count == 1){
                this.tail = null;
            } else {
                ((DNode<E>) this.head).setPrev(null);
            }
        } else if(index == this.count - 1) {
            current = this.tail;
            this.tail = current.getPrev();
            if(this.tail != null) {
                this.tail.setNext(null);
            }
        } else {
            current = (DNode<E>) this.getElementAt(index);
            DNode<E> previous = current.getPrev();
            DNode<E> nextNode = (DNode<E>) current.getNext();
            previous.setNext(current.getNext());
            nextNode.setPrev(previous);
        }

        this.count--;
        return current.getValue();
    }
Analisando os cenários:
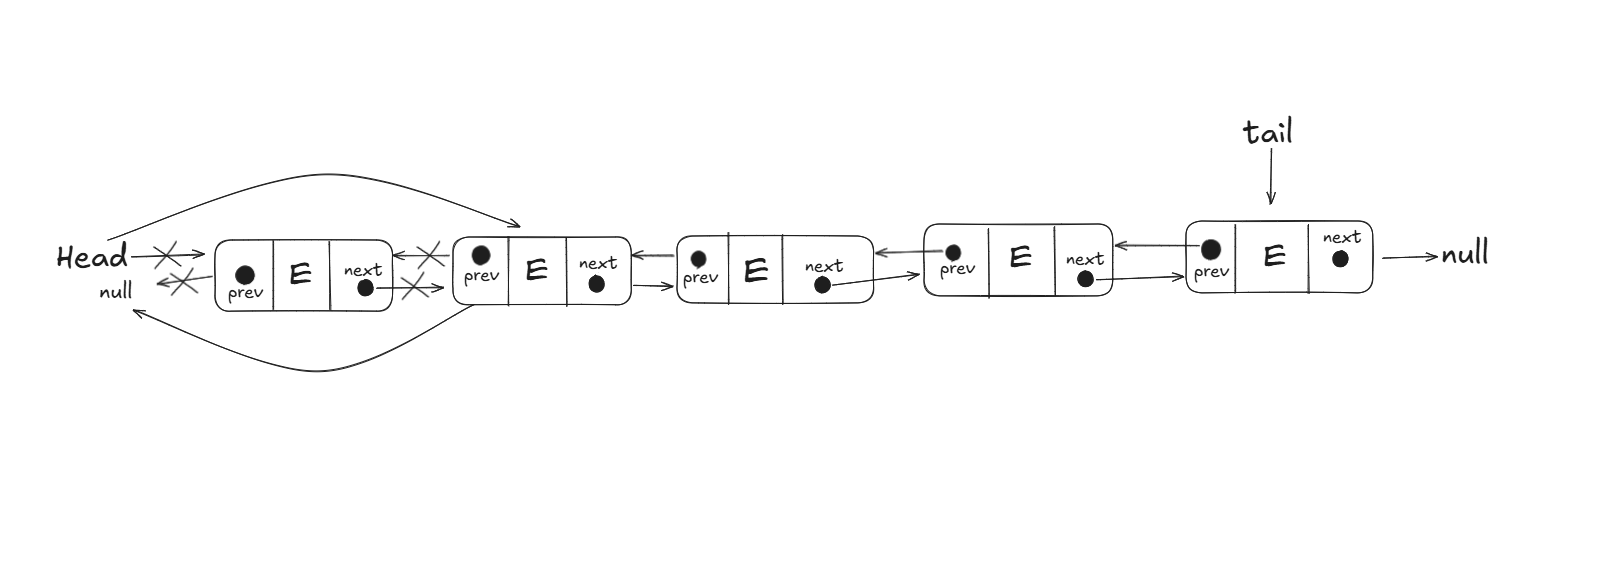
- Cenário 1 (Remoção do início - index 0): O head avança para o próximo nó. Atenção ao detalhe crucial: se a lista só tinha 1 elemento (count == 1), ao removermos, a lista fica vazia, logo o tail também deve virar null. Caso contrário, garantimos que o prev do novo head seja desconectado (null).
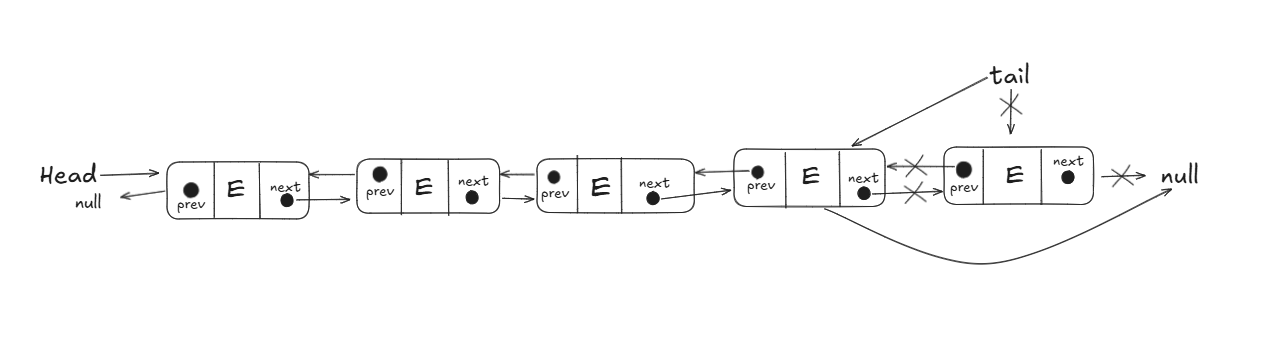
- Cenário 2 (Remoção do final - index == count - 1): Não precisamos iterar a lista toda. Basta acessar o tail, pegar o nó anterior a ele (current.getPrev()), elegê-lo como o novo tail e cortar sua conexão next.
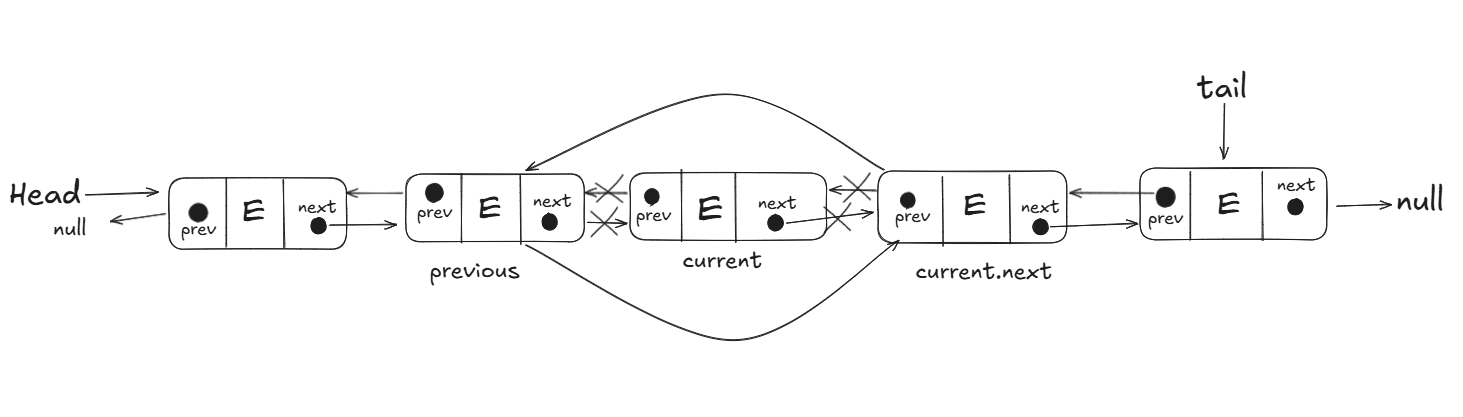
- Cenário 3 (Remoção no meio): Identificamos o nó que será removido (current). Para isolá-lo, pegamos o seu antecessor e o fazemos apontar diretamente para o seu sucessor, e vice-versa. Assim, o current é excluído da corrente.
Acessando a Cauda (getTail)
Adicionamos também o método getTail(), que nos permite inspecionar diretamente a cauda da lista. Casando com o que temos em nossa lista ligada simples, o metodo getHead() que nos permite acessar a cabeça da lista, como parte da herança temos acesso a esse e todos os outros metodos como: getElementAt, indexOf, size, isEmpty, toString sem que precisemos alterar a estrutura dos métodos feitos na estrutura anterior.
    public DNode<E> getTail() {
        return this.tail;
    }
Conclusão
Implementar uma Lista Duplamente Ligada nos mostra como pequenas adições — como o ponteiro prev e a referência tail — podem otimizar a performance da nossa estrutura, permitindo navegação bidirecional e operações quase instantâneas no final da lista.
Apesar de exigir um pouco mais de memória e atenção redobrada para não quebrar as referências durante as inserções e remoções, o ganho de flexibilidade compensa o esforço. Além disso, ao utilizarmos a Herança, provamos que é possível criar estruturas complexas escrevendo menos código e reaproveitando lógicas já validadas.
O código implementado nesta publicação está disponivel no seguinte repositório: https://github.com/ThalesSilva67/data-structure
Referências
- GOODRICH, Michael T.; TAMASSIA, Roberto. Estruturas de Dados e Algoritmos em Java. 5. ed. Porto Alegre: Bookman, 2013.
- GRONER, Loiane. Estruturas de dados e algoritmos com JavaScript: escreva um código JavaScript complexo e eficaz usando os recursos mais recentes do ECMAScript. 2. ed. São Paulo: Novatec Editora, 2019. 408 p